Ce que fait le lip-sync
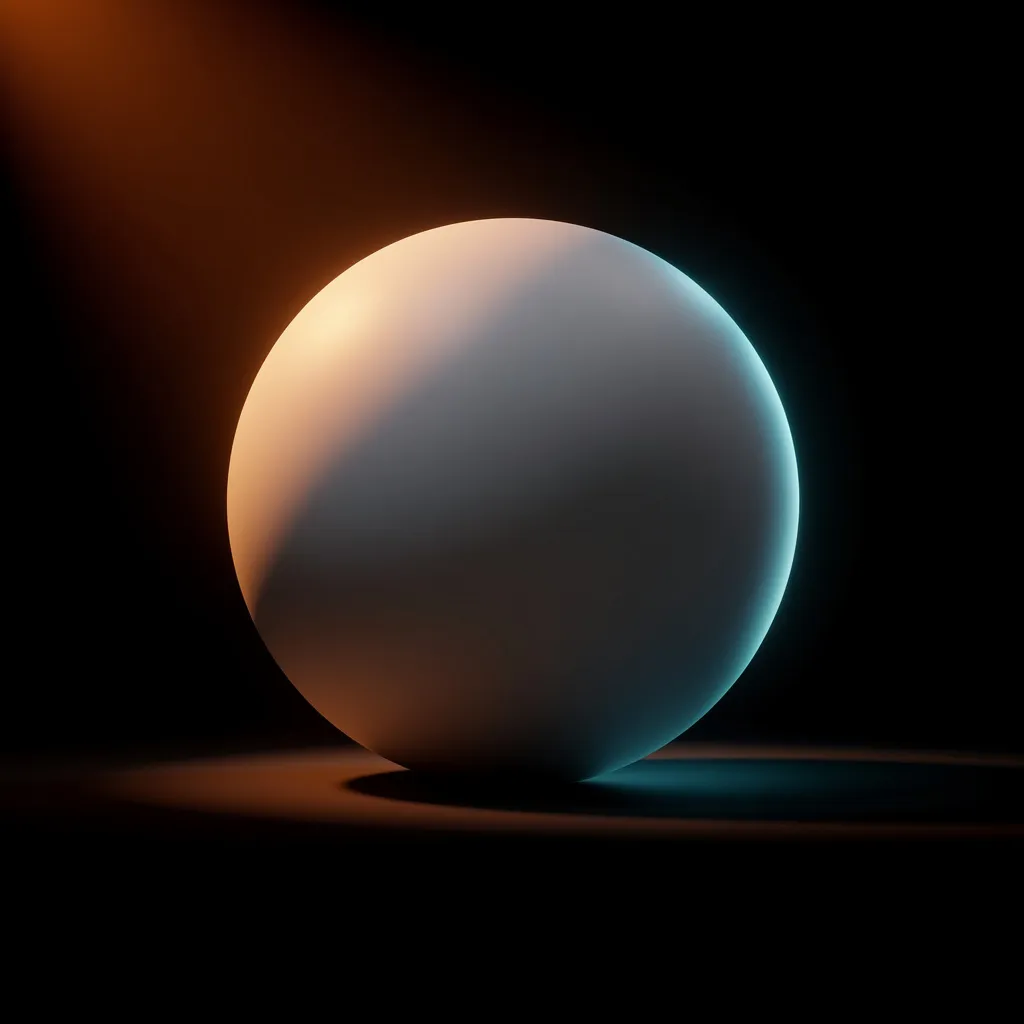
Le modèle ne crée pas la voix : il anime une bouche sur l'audio que vous lui donnez. Deux cas. Avec un portrait et un audio, il produit une vidéo où la personne parle, aussi longue que l'audio. Avec une vidéo et un audio, il recale le mouvement des lèvres sur la nouvelle voix. Le coût suit la durée exacte du fichier, mesurée avant tout débit. Arrivé avec eux, MiniMax H3 Max Relight rééclaire une vidéo d'après l'image d'une sphère d'éclairage.
7 modèles
4 pour faire parler un portrait, 3 pour doubler une vidéo existante
1 à 30 s
d'audio pour un portrait, selon le modèle : la vidéo dure l'audio
WAV · M4A
pour l'audio, WAV seul avec OmniHuman v2 ; un MP3 est à convertir
Exemples générés sur Beemm Vision
Les quatre étapes
Étape 1
Choisir le cas : un portrait ou une vidéo
Pour faire parler une image, prenez un modèle de type Avatar : Kling AI Avatar v2, MiniMax H3 Max Lip Sync, OmniHuman v2 ou sync-3 Avatar. Pour doubler une vidéo, un modèle de type Lip-sync : sync-3 Lipsync, Kling LipSync ou HeyGen Lipsync. Dans Generate, le menu des modèles les range sous ces deux types ; sur le canvas, ajoutez le nœud du modèle.
Étape 2
Préparer l'image, la vidéo et l'audio
Le portrait : un visage de face, la bouche visible. sync-3 Avatar accepte aussi une illustration. L'audio : un fichier WAV ou M4A, WAV seulement pour OmniHuman v2 ; un MP3 est refusé avant débit, convertissez-le d'abord. La vidéo à doubler : un MP4 ou un MOV. Utilisez votre voix, ou une voix dont vous avez les droits.
Étape 3
Joindre les fichiers et régler le modèle
Dans Generate, déposez l'image ou la vidéo, puis l'audio dans la case « Voix ». Sur le canvas, importez les fichiers et branchez-les sur les entrées Image, Video et Audio du nœud. Kling AI Avatar v2 se règle en Standard ou Pro, MiniMax H3 Max Lip Sync de 480P à 2K (768P par défaut), HeyGen Lipsync en Speed ou Precision. Sur le canvas, sync-3 Lipsync vous laisse choisir quoi faire quand la vidéo et l'audio n'ont pas la même durée.
Étape 4
Respecter les durées, puis lancer
Pour un portrait, la vidéo dure l'audio : de 2 à 30 s avec Kling AI Avatar v2, de 5 à 30 s avec MiniMax H3 Max Lip Sync, de 4 à 30 s avec OmniHuman v2, de 1 à 30 s avec sync-3 Avatar. Pour un doublage : 1 à 30 s avec sync-3 Lipsync et HeyGen Lipsync, une vidéo de 2 à 10 s avec Kling LipSync. Generate affiche le coût dès que le fichier est mesuré ; hors de ces bornes, la génération est refusée avant débit.
Les modèles en un tableau
| Cas | Modèles et durées acceptées | Conseil |
|---|---|---|
| Portrait + voix | Kling AI Avatar v2 (2 à 30 s), MiniMax H3 Max Lip Sync (5 à 30 s), OmniHuman v2 (4 à 30 s), sync-3 Avatar (1 à 30 s) | La vidéo dure l'audio ; sync-3 Avatar accepte une illustration |
| Vidéo + voix | sync-3 Lipsync (1 à 30 s), Kling LipSync (vidéo de 2 à 10 s, audio de 2 à 60 s), HeyGen Lipsync (1 à 30 s) | HeyGen : l'audio doit être plus court que la vidéo, qui garde sa durée |
| Écart de durées | sync-3 Lipsync : couper au plus court, boucler, aller-retour, ralentir ou accélérer, compléter par du silence | Réglage du nœud ; il fixe la durée de sortie, donc le coût |
| Rééclairer | MiniMax H3 Max Relight : une vidéo de 2,4 à 15 s et l’image d’une sphère d’éclairage | 768P par défaut, jusqu’à 2K ; la vidéo garde sa durée |
| Formats | Audio WAV ou M4A, vidéo MP4 ou MOV | OmniHuman v2 : WAV seulement ; un MP3 est refusé avant débit |
Idées d'usage
Un présentateur pour une vidéo produit
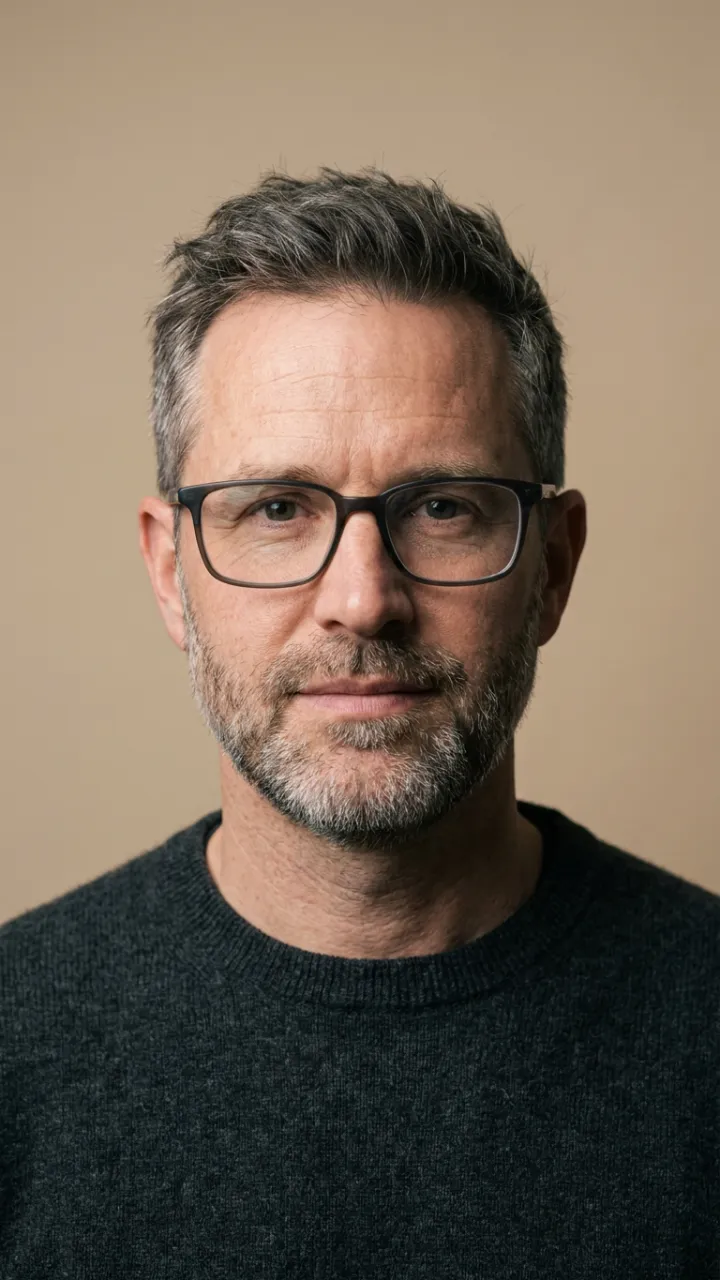
Un portrait de face et votre texte enregistré en WAV : Kling AI Avatar v2 ou MiniMax H3 Max Lip Sync rendent une vidéo de la durée de l'audio.
Une mascotte qui parle
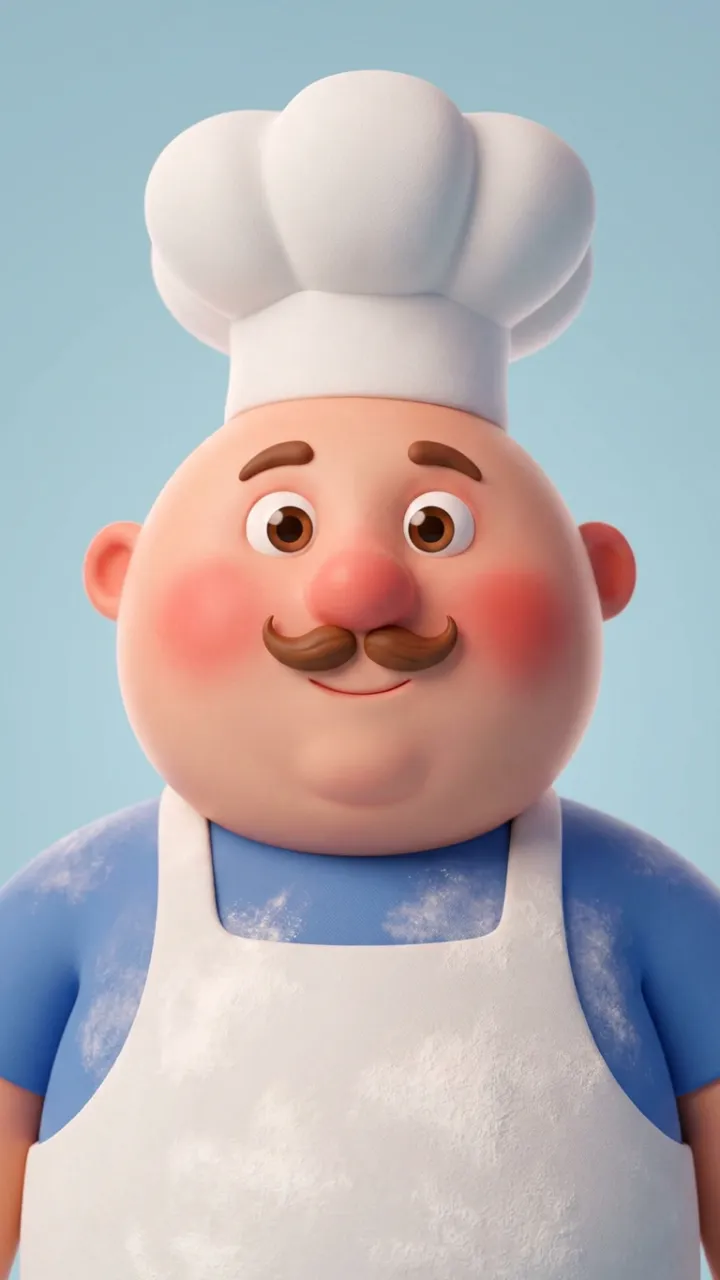
sync-3 Avatar anime aussi une illustration : la mascotte de votre marque lit votre message. Pour la garder identique d’une image à l’autre, voyez le guide Personnage cohérent.
Une vidéo doublée
Enregistrez la version traduite, puis sync-3 Lipsync ou HeyGen Lipsync recalent les lèvres de la vidéo d'origine sur la nouvelle voix.
Changer la lumière d'une scène
MiniMax H3 Max Relight rééclaire une vidéo d'après l'image d'une sphère qui montre l'éclairage voulu.
Questions fréquentes
- Comment faire parler une photo avec l'IA ?
- Joignez un portrait de face et un fichier audio à un modèle de type Avatar : Kling AI Avatar v2, MiniMax H3 Max Lip Sync, OmniHuman v2 ou sync-3 Avatar. Le modèle anime la bouche sur l'audio, et la vidéo dure autant que lui.
- Quel format audio faut-il ?
- Du WAV ou du M4A ; OmniHuman v2 n'accepte que le WAV. Un MP3 est refusé avant débit, car sa durée ne se mesure pas exactement : convertissez-le d'abord en WAV ou en M4A.
- Combien de temps peut durer la vidéo ?
- Pour un portrait, jusqu'à 30 secondes, la durée de l'audio : au moins 1 à 5 secondes selon le modèle. Pour un doublage, 30 secondes avec sync-3 Lipsync et HeyGen Lipsync, 10 secondes de vidéo avec Kling LipSync.
- Peut-on doubler une vidéo dans une autre langue ?
- Oui, avec la voix traduite en fichier audio : sync-3 Lipsync, Kling LipSync ou HeyGen Lipsync recalent les lèvres dessus. Le modèle ne traduit pas : il synchronise les lèvres sur l'audio que vous fournissez.
- Combien coûte un lip-sync ?
- Le coût suit la durée exacte de l'audio ou de la vidéo, mesurée avant tout débit, et dépend du modèle et de son réglage. Generate l'affiche dès que le fichier est mesuré. Un fichier hors bornes ou illisible est refusé avant débit.
- Les sept modèles sont-ils ouverts à tous les comptes ?
- HeyGen Lipsync et OmniHuman v2 n'ont pas de filtre chez leur fournisseur : ils sont réservés aux comptes qui ont déclaré être majeurs. Les autres comptes disposent de Kling AI Avatar v2, MiniMax H3 Max Lip Sync, sync-3 Avatar, sync-3 Lipsync et Kling LipSync.
Faire parler votre premier portrait
Ouvrez le studio, choisissez un modèle de type Avatar dans Generate, puis joignez un portrait de face et votre voix en WAV ou M4A.